Im Online-Handel führen fehlende Produktattribute häufig zu Null-Treffern und damit zu Kaufabbrüchen. Wenn Suchbegriffe nicht mit den im Katalog vorhandenen Beschreibungen übereinstimmen, verlassen Kund*innen die Seite, obwohl das gesuchte Produkt vorrätig ist. Ein multimodaler Ansatz, der Bild- und Textinformationen in einem gemeinsamen Vektorraum verknüpft, schließt diese Lücke gezielt. Die vorgestellte Forschungsarbeit demonstriert, wie ein speziell finetuned LLaVA-13B-Modell für Bildbeschreibungen und ein kontrastiv trainiertes CLIP-Modell für die Vektorisierung zusammen mit einer ChromaDB-Vektordatenbank die Such-UX fundamental verbessern können.
Technische Architektur und Modelloptimierung
Bildbeschreibung mit LLaVA-13B (LoRA-Finetuning)
Das Kernstück der Bild-zu-Text-Umwandlung ist ein LLaVA-13B-Modell, das mittels Low-Rank-Adaptation (LoRA) auf mehr als 250.000 Bild-Text-Paare aus Plattformen wie Amazon, Noon, Primark und dem Kaggle-Fashion-Datensatz angepasst wurde. Das Finetuning fokussiert sich auf die Extraktion von Attributen wie Farbe, Material und Form und blendet irrelevante Bildbestandteile aus. Die menschliche Qualitätsbewertung lag bei 80,57 %, verglichen mit 62,89 % des Basismodells ohne domänenspezifisches Finetuning.
Vektorisierung und semantischer Abgleich mit CLIP und ChromaDB
Für den eigentlichen Abgleich wandelt das CLIP-Modell sowohl Bild- als auch Textanfragen in numerische Vektorrepräsentationen um. Diese Vektoren werden in der Vektordatenbank ChromaDB gespeichert und mittels Kosinus-Ähnlichkeit abgeglichen. Durch diese Methode findet die Suche auch dann passende Produkte, wenn das gesuchte Attribut im Text nicht vorkommt, weil das Attribut bereits im Bild verankert ist.
Datenaufbereitung und Qualitätsbewertung
Vor dem Training wurden Bilder standardisiert, fehlerhafte Datensätze entfernt und Beschreibungen bereinigt. GPT-4 unterstützte die Bereinigung der Trainingsdaten, um konsistente und rechtlich sichere Beschreibungen zu gewährleisten. Die umfassende Datenkuration ermöglichte eine robuste Modell-Performance über verschiedene Modekategorien hinweg.
Ökonomische Dimension von “Search Abandonment”
Eine Google-Cloud-Studie in Zusammenarbeit mit The Harris Poll aus dem Jahr 2023 quantifiziert die wirtschaftlichen Folgen unzureichender Suchfunktionen: über 2 Billionen US-Dollar Jahresverlust weltweit. Gleichzeitig gibt 53 % der befragten Konsumenten an, nach einer erfolglosen Suche den gesamten Warenkorb zu verwerfen und zum Wettbewerb zu wechseln. Diese Zahlen verdeutlichen, warum Investitionen in multimodale Vektorsuchen nicht nur ein technisches Upgrade, sondern eine strategische Notwendigkeit darstellen.
Usability-Defizite im Standard-E-Commerce
Das Baymard-Institute-Benchmark von 2026 analysierte mehr als 170 führende E-Commerce-Plattformen und ergab, dass 56 % der Shops bei komplexen Attribut- und Bild-Queries signifikante Usability-Probleme aufweisen. Gleichzeitig nutzt etwa 50 % der Online-Shopper die Suchfunktion als primäre Navigationsmöglichkeit. Die Kombination aus hoher Nutzungsrate und schlechter UX führt zu häufigen Null-Treffern und damit zu verlorenen Umsätzen.
Wie Bilder und Wörter zusammengeführt werden
Der Kern des Systems besteht aus zwei zusammenarbeitenden Modellen. LLaVA erzeugt aus jedem Produktfoto eine verständliche, handelsnahe Beschreibung, wobei fünf gezielte Fragen pro Bild gestellt werden, um Attribute wie Farbe, Form und Material klar zu extrahieren. Anschließend verarbeitet CLIP sowohl diese Beschreibungen als auch die eingehenden Suchanfragen (Text oder Bild) zu Vektoren, die in derselben semantischen Ebene liegen. Durch die Speicherung in ChromaDB kann die Suche in Echtzeit Ähnlichkeiten über den Kosinus-Wert berechnen und relevante Artikel zurückliefern.
Ein Zitat aus der Fachzeitschrift “AI” unterstreicht den Fortschritt: “Der Prototyp verbessert die Trefferquote auf 95 % bei den ersten fünf Ergebnissen und reduziert die Antwortzeit von 2,5 auf 1,2 Sekunden.”
Messbare Fortschritte, begrenzte Aussagekraft
In kontrollierten Labortests zeigte der angepasste Prototyp eine deutliche Leistungssteigerung:
- Top-5-Trefferquote: von 70 % auf 95 % (+25 Prozentpunkte)
- Reaktionszeit: von 2,5 s auf 1,2 s
- Qualitätsbewertung der Bildbeschreibungen: 80,57 %
Diese Kennzahlen beruhen jedoch auf einem Vergleich mit der eigenen Vorversion. Ein breiterer Benchmark gegenüber etablierten Lösungen wie Algolia NeuralSearch oder Google Retail Search fehlt bislang, wodurch die Aussagekraft für den produktiven Einsatz begrenzt bleibt.
Risiken und Gegenmaßnahmen
- Inferenzkosten und Latenz im Spitzenlastbetrieb: Auch wenn 1,2 s ein Fortschritt sind, liegen die Zeiten noch über den angestrebten Sub-300-ms-Zielen großer Händler.
- Halluzinationen bei automatischer Attributierung: Fehlinterpretierte Materialangaben (z. B. “Echtleder” statt “Lederoptik”) können zu Abmahnungen und höheren Retourenquoten führen.
- Fehlende Validierung gegen State-of-the-Art-Engines: Bisher wurde nur gegen die eigene Vorversion getestet; ein Vergleich mit kommerziellen Hybridsuchmaschinen steht noch aus.
Schnellüberblick:
Wie genau verhindert multimodale Suche Null-Treffer bei Modeartikeln?
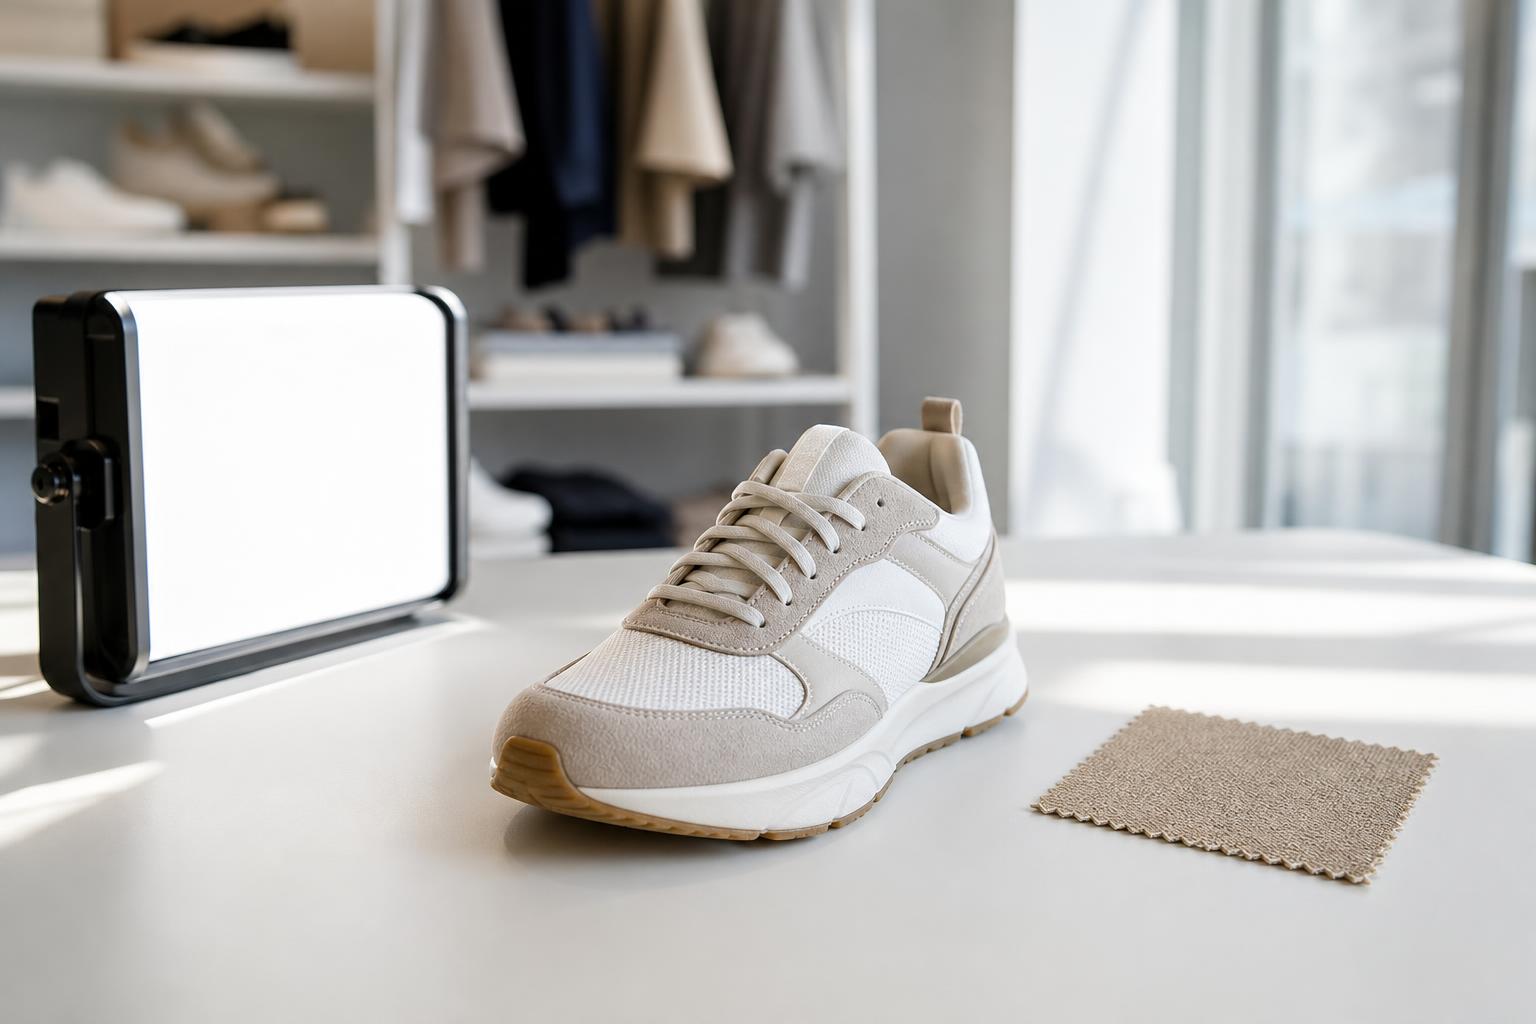
Statt starre Schlagwörter abzugleichen, bettet ein Vision-Language-Modell wie CLIP Bilder und Textanfragen in denselben mathematischen Vektorraum ein. Kund*innen finden so beispielsweise Sneaker mit “transparenter Sohle”, selbst wenn das Wort in der Produktbeschreibung fehlt.
Wie hoch ist der wirtschaftliche Schaden durch unzureichende Shop-Suchen?
Laut Google-Cloud- und Harris-Poll-Erhebungen führt “Search Abandonment” weltweit zu jährlichen Umsatzverlusten von über 2 Billionen US-Dollar. Mehr als die Hälfte der betroffenen Kund*innen verlässt den Shop nach einer Null-Suche vollständig und kauft beim Wettbewerb.
Welche technischen Komponenten ermöglichen die Bild-Text-Integration?
Die Pipeline kombiniert ein LoRA-feingetunetes LLaVA-13B-Modell für die Bild-zu-Text-Übersetzung, ein kontrastiv trainiertes CLIP-Modell für die Vektorisierung und ChromaDB für den semantischen Abgleich.
Quellen
- https://doi.org/10.3390/ai7100437
- https://baymard.com/blog/ecommerce-search-ux
- https://cloud.google.com/blog/topics/retail/new-research-on-search-abandonment-in-retail