
Im Zeitalter des Agentic Commerce treffen autonome KI-Agenten eigenständig Kaufentscheidungen – und das ausschließlich auf Basis maschinenlesbarer Produktattribute. Fehlende, ungenaue oder inkonsistente Stammdaten führen nicht nur zu Fehlempfehlungen, sondern kosten Unternehmen jährlich Millionen. Dieser Artikel beleuchtet, warum ein robustes Product Information Management (PIM) die Grundvoraussetzung für erfolgreiche KI-Anwendungen ist.
Das GIGO-Prinzip im Agentic Commerce
„Garbage In, Garbage Out“ (GIGO) beschreibt die Kernlogik, dass KI-Systeme nur so gut sind wie die Daten, die sie erhalten. Wie ein Experte betont: „KI ist keine Müllabfuhr für schlechte Produktdaten.“ Autonome Einkaufsagenten können unstrukturierte oder fehlerhafte Stammdaten nicht eigenständig verlässlich korrigieren. Stattdessen verstärken sie Fehlermuster und erhöhen das Risiko von Fehlbestellungen und Retouren.
Wirtschaftliche Kosten mangelhafter Datenqualität
Die finanziellen Folgen unzureichender Daten sind beachtlich. Laut einer Gartner-Erhebung (2021) entstehen durchschnittlich 12,9 Millionen US-Dollar pro Unternehmen jährlich durch ineffiziente Prozesse, Fehlentscheidungen und Datenbereinigungsaufwand. Eine weitere Studie von Thomas Redman (MIT Sloan Management Review, 2017) quantifiziert den Umsatzverlust auf 15 % bis 25 % aufgrund von Datenfehlern und Inkonsistenzen.
- Durchschnittliche jährliche Kosten mangelhafter Datenqualität: 12,9 Mio. USD (2021)
- Umsatzverlust durch Datenqualität: 15 %-25 % (2017)
- Erwartete Adaptionsrate von Agentic Shopping bei Konsumenten: 46 % bis Ende 2026
Diese Kennzahlen verdeutlichen, dass schlechte Daten nicht nur ein technisches, sondern ein erhebliches ökonomisches Risiko darstellen.
Von AI-ready zu Agent-ready: Anforderungen an Produktdaten
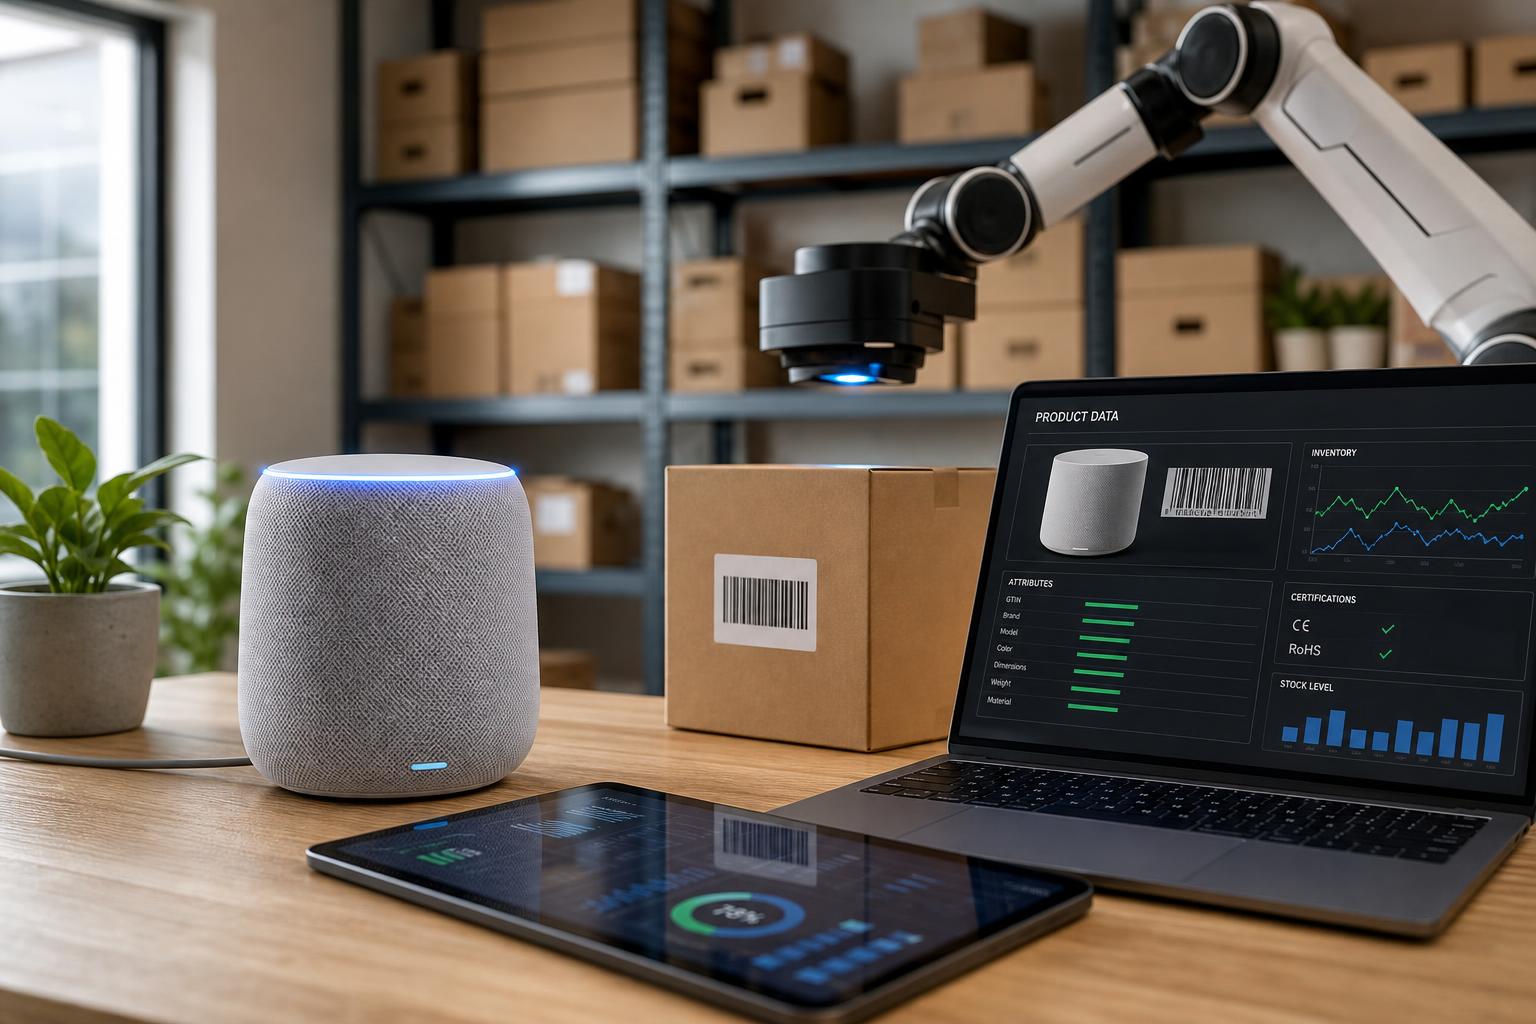
„AI-ready“ bedeutet häufig nur, dass Texte für semantische Suchen auffindbar sind. Für den Agentic Commerce reicht das jedoch nicht aus. „Agent-ready“ verlangt standardisierte, validierte Attribute – zum Beispiel GTINs, exakte Maßangaben, Echtzeit-Bestand und strukturierte Zertifikate. Ohne diese Daten können autonome KI-Agenten Produkte nicht verarbeiten und ignorieren sie komplett.
Der Wandel vom klassischen E-Commerce zum Agentic Commerce verlagert die zentrale Schnittstelle von Frontend-Design zu maschinenlesbaren APIs und Protokollen wie dem Agentic Experience Protocol (AXP) oder dem Agentic Commerce Protocol (ACP). Fehlen normalisierte Einheiten, kann ein Shop für Bots technisch nicht „kaufbar“ sein.
- Standardisierte GTINs
- Normalisierte Maßangaben (z. B. Länge, Breite, Gewicht)
- Echtzeit-Bestandsinformationen
- Strukturierte Zertifikate und Compliance-Attribute
- Maschinenlesbare Feed- und Protokollstandards (AXP, ACP)
Wie autonome KI-Agenten Kaufentscheidungen treffen
Agenten selektieren Angebote primär nach strukturierten Attributen und Datenintegrität. Sie durchsuchen Produkt-Feeds nach gültigen GTINs, prüfen Maßangaben und vergleichen Echtzeit-Bestände. Fehlen diese Informationen, wird das Produkt aus dem Entscheidungsprozess herausgefiltert – unabhängig von ansprechenden Werbetexten oder Bildmaterial.
Der Mythos, moderne KI-Systeme könnten unvollständige Kataloge im Vorbeigehen heilen, entpuppt sich als teurer Irrtum. Stattdessen beschleunigt KI die Skalierung von Fehlern: „Eine KI arbeitet hocheffizient – auch wenn sie Fehler vorbereitet.“
Der verstärkte GIGO-Effekt durch autonome Agenten
Generative KI und Agentensysteme korrigieren fehlerhafte Daten nicht magisch, sondern beschleunigen die Fehlerkette. Unpräzise Maßangaben, fehlende Kompatibilitäten oder unklare Attributwerte führen im automatisierten Einkauf zu Fehlbestellungen, hohen Retourenquoten und dem völligen Ausschluss aus KI-gestützten Such- und Kaufprozessen.
Obwohl Large-Language-Models (LLMs) syntaktische Bereinigungen unterstützen können, sind sie nicht in der Lage, fehlende Fakten wie exakte Maße oder Freigaben zu erfinden, ohne zu halluzinieren. Der initiale Bereinigungsaufwand bleibt hoch und muss von Händlern realistisch eingeplant werden.
Schnellüberblick:
Warum kann generative KI fehlende Produktdaten nicht einfach ergänzen?
Generative Modelle basieren auf Wahrscheinlichkeiten, nicht auf physikalischer Wahrheit. Fehlen technische Spezifikationen, neigen Modelle zu Halluzinationen, was im Handel zu falschen Kundenerwartungen, Haftungsrisiken und hohen Retourenkosten führt.
Was unterscheidet ‚AI-ready‘ von ‚Agent-ready‘ bei Produktdaten?
‚AI-ready‘ bedeutet oft nur, dass Texte für semantische Suchen auffindbar sind. ‚Agent-ready‘ verlangt standardisierte, validierte Attribute (z. B. GTIN, exakte Maße, Echtzeit-Bestand), damit autonome KI-Agenten Verträge und Käufe ohne menschliches Eingreifen abschließen können.
Wie stark verstärkt der Einsatz autonomer Agenten den GIGO-Effekt?
Durch die regelbasierte, datengetriebene Entscheidungslogik filtern Agenten fehlende oder inkonsistente Attribute sofort aus, wodurch fehlerhafte Produkte gar nicht erst in den Kaufprozess gelangen. Das führt zu einer schnelleren Skalierung von Datenfehlern im Vergleich zu menschlichen Nutzer:innen.
Welche Protokoll- und Feed-Standards sind für Agentic Commerce entscheidend?
Das Agentic Experience Protocol (AXP) und das Agentic Commerce Protocol (ACP) definieren maschinenlesbare Formate, standardisierte Einheiten und Echtzeit-Informationen, die für die Anbindung autonomer Einkaufsagenten unabdingbar sind.
Quellen
- https://www.gartner.com/en/data-analytics/topics/data-quality
- https://sloanreview.mit.edu/article/seizing-opportunity-in-data-quality/
- https://www.braze.com/resources/articles/agentic-commerce