
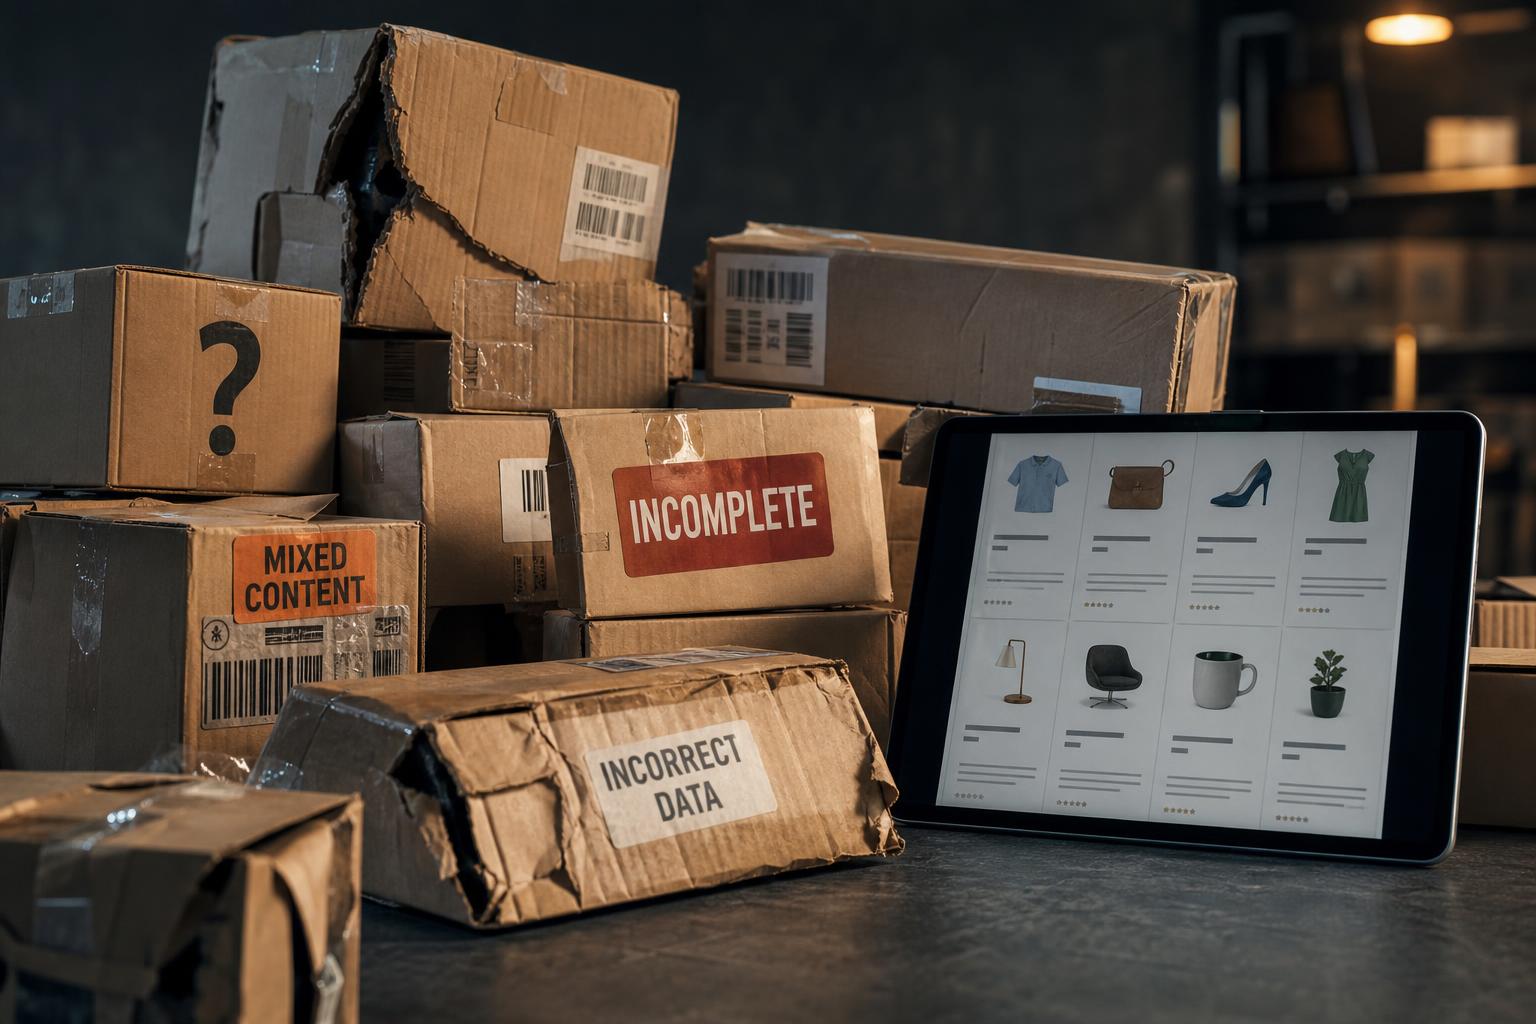
Moderne Handelsunternehmen setzen immer stärker auf Künstliche Intelligenz (KI), um Produktinformationen zu verwalten, zu übersetzen und kanalübergreifend zu verbreiten. Doch wenn die zugrundeliegenden Produktdaten unvollständig, inkonsistent oder in Silos gespeichert sind, verwandelt sich die KI von einem Beschleuniger in einen Verstärker von Fehlern. Dieser GIGO-Effekt (Garbage-in-Garbage-out) erklärt, warum zahlreiche Generative-AI-Initiativen im E-Commerce scheitern und welche finanziellen Konsequenzen daraus entstehen.
Warum KI keine automatische Datenbereinigung ist
Ein zentrales Missverständnis lautet, KI könne schlechte Bestandsdaten wie eine Müllabfuhr entsorgen. Wie Dominik Grollmann betont:
„KI ist keine Müllabfuhr für schlechte Produktdaten.“
Und weiter:
„Eine KI arbeitet hocheffizient – auch wenn sie Fehler vorbereitet.“
Ohne klare Klassifikationsstandards, einheitliche Attributsets und saubere Schnittstellen zu ERP-Systemen bleibt die KI jedoch anfällig für Halluzinationen und fehlerhafte Produktbeschreibungen.
Der GIGO-Effekt im Product Information Management (PIM)
Produktdaten, die aus Quellsystemen mit fehlenden Maßeinheiten, uneinheitlichen Attributbezeichnungen oder veralteten Beständen stammen, führen zu einer Kettenreaktion:
- Automatisierte KI-Prozesse verbreiten inkorrekte Informationen über alle angeschlossenen Marktplätze und Kanäle.
- Shop-Suchfunktionen und Filter können relevante Artikel nicht mehr finden – die Sichtbarkeit sinkt drastisch.
- Fehlklassifizierte Produkte erzeugen falsche Kundenerwartungen, was zu höheren Retourenraten führt.
Nach Gartner-Analysen (2024) scheitern mindestens 30 % der generativen KI-Projekte nach der Proof-of-Concept-Phase – ein Großteil davon wegen mangelhafter Datenqualität und unklarer Wertschöpfung.
Quantitative Folgen mangelhafter Daten
Die finanziellen Auswirkungen lassen sich anhand etablierter Kennzahlen verdeutlichen:
- Durchschnittliche jährliche Kosten mangelhafter Datenqualität: 12,9 Millionen USD pro Unternehmen (Gartner, 2021).
- Abbruchquote von Generative-AI-Projekten nach PoC: 30 % (Gartner, 2024).
- Bearbeitungskosten pro Retoure: 5 bis 20 Euro (EHI Retail Institute, 2024).
- 75,2 % der befragten Online-Händler in der DACH-Region bewerten detaillierte Produktangaben als wichtigste Maßnahme zur Retourenreduktion (EHI Retail Institute, 2024).
Diese Zahlen zeigen, dass schlechte Daten nicht nur ein technisches, sondern ein betriebswirtschaftliches Problem darstellen.
Retourenprävention durch präzise Produktattribute
Im E-Commerce gilt präzise, kanalgerechte Produktinformation als stärkste Waffe gegen teure Rücksendungen. Wenn KI-gestützte Systeme fehlerhafte Attributwerte erzeugen, landen Produkte zwar im Warenkorb, aber schnell im Retourenzentrum. Das EHI Retail Institute weist darauf hin, dass die Kosten pro Rücksendung von bis zu 20 Euro unmittelbar die Marge schmälern.
Die Lösung liegt in einer klaren Datenstrategie:
- Einheitliche Taxonomien (z. B. ETIM, eCLASS) etablieren.
- Master-Data-Strukturen im ERP und PIM konsistent pflegen.
- Automatisierte Validierungs-Workflows einsetzen, um fehlende oder fehlerhafte Attribute zu identifizieren, bevor sie in KI-Modelle fließen.
Wie KI-Readiness im PIM konkret aussieht
„Ein PIM-System ist erst dann KI-fähig, wenn klare Klassifikationsstandards, eindeutige Attributsets und saubere Schnittstellen zu Vorsystemen existieren“, erklärt ein Experte. Auf dieser Basis können KI-Anwendungen zuverlässig Übersetzungen, Textgenerierungen und Kanal-Mappings durchführen.
Schnellüberblick:
Kann generative KI unvollständige Produktattribute nicht einfach selbstständig ergänzen?
KI kann unstrukturierte Texte analysieren und standardisieren, aber keine fehlenden physikalischen oder technischen Spezifikationen (wie Maße oder Materialzertifikate) eigenständig erfinden. Ohne menschliche Freigabe oder feste Datenvalidierung drohen fehlerhafte Filterwerte und Kundenreklamationen.
Was bedeutet ‚KI-Readiness‘ im Produktdatenmanagement konkret?
Ein PIM-System ist erst dann KI-fähig, wenn klare Klassifikationsstandards (z. B. ETIM oder eCLASS), eindeutige Attributsets und saubere Schnittstellen zu Vorsystemen (wie ERP) existieren. Erst auf einer solchen sauberen Basis kann KI Aufgaben wie Übersetzung, Textgenerierung oder Kanal-Mapping fehlerfrei ausführen.
Quellen
- https://www.gartner.com/en/newsroom/press-releases/2024-07-29-gartner-predicts-30-percent-of-generative-ai-projects-will-be-abandoned-after-proof-of-concept-by-end-of-2025
- https://www.gartner.com/en/data-analytics/insights/data-quality
- https://www.ehi.org/presse/versand-und-retourenmanagement-im-e-commerce-2024/